Home / Riconoscere immagini IA
Come capire se una foto è generata dall'IA
Due livelli di analisi, mostrati separatamente: il nostro modello proprietario (Vision Transformer addestrato da Acquisizioni Forensi) e le analisi indipendenti da esso: 8 test forensi riproducibili, tre detector di terze parti (Community Forensics, SMOGY, CLIP), provenienza C2PA e metadati. Il verdetto finale li combina, con astensione quando l'evidenza manca.
Analizza la tua immagine per verificare se è creata con AI
Carica un'immagine per scoprire se è stata generata o manipolata con intelligenza artificiale. La analizzano il nostro modello proprietario (Vision Transformer addestrato da Acquisizioni Forensi) e, in una scheda separata, analisi indipendenti da esso: 8 test forensi riproducibili, tre detector di terze parti, provenienza C2PA e metadati. Il verdetto combinato pesa tutti i metodi e dichiara quelli che si astengono.
I segnali che puoi controllare da solo
A occhio si riesce ancora, ma sempre meno. I segnali qui sotto sono quelli che si possono controllare senza strumenti, ordinati da quello che oggi funziona meglio a quello che ormai funziona poco. Nessuno di questi è una prova: servono a farsi un’idea, e quando l’idea non basta si passa all’analisi.
1. I metadati — il segnale più solido
Una foto scattata porta con sé i dati della fotocamera: marca, modello, obiettivo, tempi, ISO. Un’immagine generata non li ha, oppure porta il nome dello strumento che l’ha prodotta.
Dal 2024 molti generatori inseriscono anche credenziali C2PA o il watermark SynthID di Google: quando ci sono, la questione è chiusa. Puoi leggerli con l’estrattore di metadati EXIF.
2. Luci, ombre e riflessi
È la cosa che i modelli sbagliano più a lungo, perché richiede coerenza su tutta la scena: ombre che cadono in direzioni diverse, un riflesso in una vetrina o in un occhio che non corrisponde a ciò che dovrebbe riflettere, una fonte di luce che non si vede da nessuna parte.
3. Il testo dentro l’immagine
Insegne, targhe, etichette, libri sullo sfondo: spesso le lettere sono plausibili ma non formano parole, o la stessa scritta cambia da un punto all’altro. Migliora in fretta — i modelli del 2026 scrivono molto meglio di quelli del 2024 — ma resta un punto debole sui dettagli piccoli.
4. Lo sfondo e le ripetizioni
Allontanandosi dal soggetto la scena si fa approssimativa: volti della folla che si sfaldano, motivi di un tessuto o di una ringhiera che si ripetono identici, oggetti che si fondono l’uno nell’altro. La stessa cosa vale per la simmetria: due orecchini diversi, la montatura degli occhiali che cambia da un lato all’altro.
5. La resa della pelle e delle superfici
Pelle senza pori né imperfezioni, con una luminosità uniforme che nessun obiettivo produce; una nitidezza costante su tutta l’immagine, dove una fotografia vera avrebbe una profondità di campo. È l’effetto «troppo perfetto».
6. Mani e denti — non fidartene più
È il consiglio più diffuso in rete ed è ormai superato: contare le dita funzionava con i modelli del 2022-2023. Quelli attuali disegnano mani corrette quasi sempre. Trovare una mano sbagliata dice ancora qualcosa; trovarla giusta non dice nulla.
Il limite di tutto questo
I modelli migliori producono già oggi immagini senza alcun segnale visibile, e i segnali qui sopra diventano più deboli a ogni versione. Al contrario, una fotografia vera può sembrare finta: un ritratto molto ritoccato ha la stessa pelle «troppo perfetta». Per questo l’occhio serve a sospettare, non a concludere — e l’analisi qui sopra guarda cose che l’occhio non vede: il rumore del sensore, gli artefatti di ricampionamento, la firma del generatore.
Come funziona il riconoscimento di immagini generate o manipolate con l'IA
Il sistema lavora su due livelli tenuti distinti. Il primo è il modello proprietario: un Vision Transformer (ViT-B/16) che abbiamo addestrato noi su un dataset di fotografie reali e generate; la sua risposta dipende dai dati di addestramento e dalla nostra calibrazione, e la dichiariamo come tale. Il secondo sono le analisi indipendenti dal modello: 8 test forensi deterministici e riproducibili tratti dalla letteratura, tre detector pubblici addestrati da terzi (Community Forensics, SMOGY, CLIP), la verifica crittografica della provenienza C2PA e la coerenza dei metadati. Il verdetto combinato pesa ogni metodo in base alla sua confidenza e mostra quali si sono astenuti. Prova subito il sistema →
Tecniche di analisi utilizzate per riconoscere immagini false
La prima tecnica è il modello proprietario, addestrato da noi. Tutte le altre sono indipendenti da esso: algoritmi pubblicati e riproducibili o modelli di terze parti. Nei risultati sono mostrate in due schede separate.
Vision Transformer multi-modale (ViT-B/16 + EXIF) Modello proprietario
Il nostro modello: un Vision Transformer (ViT-B/16) con un encoder per 17 caratteristiche EXIF e di immagine, addestrato da Acquisizioni Forensi su un dataset proprio di fotografie reali e generate. Accuratezza 95,9% sul nostro test set, cioè su generatori simili a quelli visti in addestramento: sui generatori più recenti non è garantita, e per questo non decide da solo. Dal 2026 vota con i soli pixel, perché i metadati EXIF sono falsificabili e vengono valutati a parte.
Analisi del Rumore Residuo (NLM Denoising)
Utilizziamo l'algoritmo Non-Local Means Denoising per estrarre il pattern di rumore residuo. Le immagini generate da IA presentano una varianza del rumore anomala (tipicamente < 3.0) rispetto alle fotografie autentiche. L'analisi viene effettuata su blocchi di 64x64 pixel per identificare inconsistenze locali.
Trasformata di Fourier FFT GAN-specific
⚠️ GAN-specific (Frank et al. ICML 2020): rileva artefatti periodici da transposed convolution tipici delle GAN. NON affidabile per modelli Diffusion e Autoregressivi (Gemini, GPT-4o, Midjourney). Applichiamo la Fast Fourier Transform per analizzare lo spettro di frequenza: le GAN mostrano pattern periodici con periodic_score > 0.03 e frequency_ratio tra 0.74-0.79.
Coerenza Locale dei Gradienti
Calcoliamo la coerenza locale dei gradienti su patch 16x16 per analizzare la distribuzione delle direzioni dei bordi. Le immagini IA mostrano pattern di coerenza innaturalmente uniformi rispetto alle fotografie reali. Il sistema visualizza la mappa di coerenza per identificare regioni sintetiche.
Pattern Colore (CFA/Bayer)
Convertiamo l'immagine in spazio colore LAB per analizzare la distribuzione cromatica. Le fotocamere reali applicano un filtro CFA (Bayer) che introduce correlazioni specifiche tra i canali colore — assenti nelle immagini AI. Il sistema analizza entropia, deviazione standard e rapporti tra canali per rilevare l'assenza di questa firma naturale. Basato su CVPR 2025 "Secret Lies in Color".
Decomposizione Wavelet (PyWavelets db4)
Applichiamo la trasformata wavelet discreta (DWT) con base Daubechies-4 su 4 livelli. Le immagini IA mostrano una curtosi dei coefficienti di dettaglio > 5, molto superiore alle immagini naturali. Il sistema decompone l'immagine in coefficienti di approssimazione (cA) e dettaglio (cH, cV, cD). La base db4 è validata in letteratura per il rilevamento GAN (Franzen et al., IEEE 2022).
Artefatti Spettrali DCT
Analisi degli artefatti DCT (Discrete Cosine Transform) su scala di frequenza multipla. Le immagini AI generative mostrano un eccesso di energia alle frequenze Nyquist — caratteristico del processo di upsampling interno. Il sistema calcola lo spectral score su 3 scale e confronta il profilo spettrale con quello atteso da immagini naturali. Basato su CVPR 2025 "Any-Resolution AI-Generated Image Detection by Spectral Learning".
Statistiche Pixel (Istogramma e Correlazioni RGB)
Analisi dell'istogramma di luminosità, correlazioni tra canali RGB e varianza locale. Le immagini AI presentano istogrammi più regolari (assenza del rumore di quantizzazione da sensore), correlazioni RGB troppo uniformi e variance dei blocchi locali ridotta. Il sistema calcola histogram_roughness, channel_correlations e block_variance_cv per rilevare pattern sintetici.
NPR — Upsampling Residual Analysis AR Models
Analisi dei residui di upsampling ispirati al NPR (Nearest Pixel Relationship, CVPR 2024). Questo approccio utilizza 4 kernel differenziali direzionali e analisi FFT-based del Nyquist ratio per rilevare le tracce lasciate dal decoder dei modelli autoregressivi (Gemini Imagen, GPT-4o). È il test più sensibile per modelli AR che sfuggono ai test tradizionali.
CLIP Semantic Analysis
Utilizziamo OpenAI CLIP (ViT-Base/32) per analizzare la similarità semantica dell'immagine con 18 prompt AI vs Real. Il modello confronta l'embedding visivo con descrizioni come "an AI generated image", "a synthetic image", "an image created by Midjourney" vs "a real photograph", "an authentic photo". Il sistema calcola uno score AI likelihood basato sulla similarità semantica.
Generator Fingerprinting
Identifica il generatore AI specifico basandosi su profili caratteristici di Midjourney (alta saturazione, stile artistico), Stable Diffusion (noise pattern, color bleeding), DALL-E (alta coerenza, bordi puliti) e Flux (texture realistiche, alto dettaglio). Analizza saturazione, contrasto, smoothness, edge quality e color coherence.
Watermark & Provenance Detection
Verifica crittografica dei manifest C2PA/Content Credentials (standard aperto CAI, adottato da Adobe, Google, Microsoft, OpenAI, Canon, Leica, Samsung e Pixel; Midjourney non lo emette ancora), con distinzione tra firma valida e firmatario sulla trust list, e scansione dei metadati EXIF/XMP per tool AI dichiarati. Il watermark invisibile SynthID (Google DeepMind, dal 2026 anche nelle immagini OpenAI) non è rilevabile senza gli strumenti ufficiali: il sistema lo dichiara esplicitamente come "non verificato" invece di stimarlo.
Ensemble Decision con Rejection Option
Combina tutti i metodi di analisi con pesi ottimizzati: ViT Model (30%), 8 Test Forensi (25%), CLIP (20%), Fingerprint (10%), Watermark (5% — boost dinamico al 15% in presenza di C2PA). Include rejection option: se la confidenza è < 40% o l'accordo tra metodi < 50%, il sistema indica "INCERTO". Output su 5 livelli: REALE, PROBABILMENTE REALE, INCERTO, PROBABILMENTE AI, GENERATA DA AI.
Indicatori chiave per riconoscere immagini generate da IA
- Metadati EXIF mancanti o incongruenti: Assenza di informazioni sulla fotocamera (Make, Model, Lens), mancanza di parametri di esposizione (ISO, aperture, shutter speed), software di generazione AI nei metadati
- Uniformità anomala del rumore: Varianza del rumore < 3.0 calcolata su blocchi 64x64px, rumore sintetico statisticamente diverso da quello dei sensori fotografici reali
- Pattern periodici nelle frequenze FFT (GAN-specific): Periodic score > 0.03, frequency_ratio tra 0.74-0.79, artefatti regolari da transposed convolution GAN. Non rilevante per modelli Diffusion e AR.
- Coerenza locale dei gradienti: Pattern di direzioni dei bordi troppo uniformi su scala locale, tipico delle immagini sintetiche
- Distribuzione colore anomala (assenza firma CFA): Mancanza delle correlazioni inter-canale tipiche del filtro Bayer delle fotocamere reali, distribuzione a*b* troppo uniforme
- Decomposizione wavelet anomala: Curtosi coefficienti dettaglio > 5, pattern di decadimento energetico tipico della sintesi AI su 4 livelli wavelet db4
- Artefatti spettrali DCT: Eccesso di energia alle frequenze Nyquist su scale multiple, caratteristico del processo di upsampling dei modelli generativi
- Statistiche pixel anomale: Istogramma troppo regolare (assenza rumore quantizzazione), correlazioni RGB uniformi, block variance CV ridotto
- Residui upsampling NPR: Kernel differenziali direzionali e Nyquist ratio anomalo, indicativi delle operazioni di upsampling nei decoder dei modelli autoregressivi (Gemini, GPT-4o)
- CLIP Semantic Similarity: Score AI > 60% indica alta similarità con concetti come "AI generated image", "synthetic image", "created by Midjourney/DALL-E"
- Generator Fingerprint Match: Pattern caratteristici di Midjourney, Stable Diffusion, DALL-E, Flux identificati tramite analisi statistica multi-feature
- Provenienza C2PA dichiarata: manifest Content Credentials con firma valida che dichiara uno strumento generativo (
digitalSourceType: trainedAlgorithmicMedia) o, al contrario, una fotocamera; tool AI dichiarati nei metadati EXIF/XMP. Il watermark SynthID non è rilevabile localmente e viene riportato come "non verificato" - Disaccordo tra metodi di analisi: Se l'accordo tra i vari metodi è < 50%, il risultato è considerato INCERTO e richiede revisione esperta
Il verdetto combinato pesa il nostro modello proprietario insieme alle analisi indipendenti (test forensi, Community Forensics, SMOGY, CLIP, provenienza C2PA, coerenza dei metadati) in base alla confidenza di ciascuno. Un metodo senza evidenza si astiene invece di votare; se i metodi che votano sono in forte disaccordo, l'esito è dichiarato incerto e rimandato alla revisione di un esperto. Una provenienza C2PA con firma valida prevale sulle euristiche.
Accuratezza: cosa possiamo dichiarare 2026
- ✓ Modello proprietario: 95,9% sul nostro test set (AUROC 0,993), cioè su generatori simili a quelli di addestramento
- ✓ Community Forensics: 78% medi zero-shot su 12 dataset (benchmark indipendente 2026)
- ⚠ Sui generatori più recenti (Flux, Midjourney v7, Firefly, GPT Image) tutti i detector pubblici scendono al 18-30%: un esito "autentica" non li esclude
- ✓ La provenienza C2PA con firma valida è l'unica prova, non un indizio
Metodi combinati:
- Modello proprietario
- • Vision Transformer (nostro)
- Analisi indipendenti
- • 8 test forensi riproducibili
- • Community Forensics (CVPR 2025)
- • SMOGY (Swin)
- • CLIP semantica
- • Provenienza C2PA + fingerprint
- • Coerenza dei metadati
- • Verdetto combinato con astensione
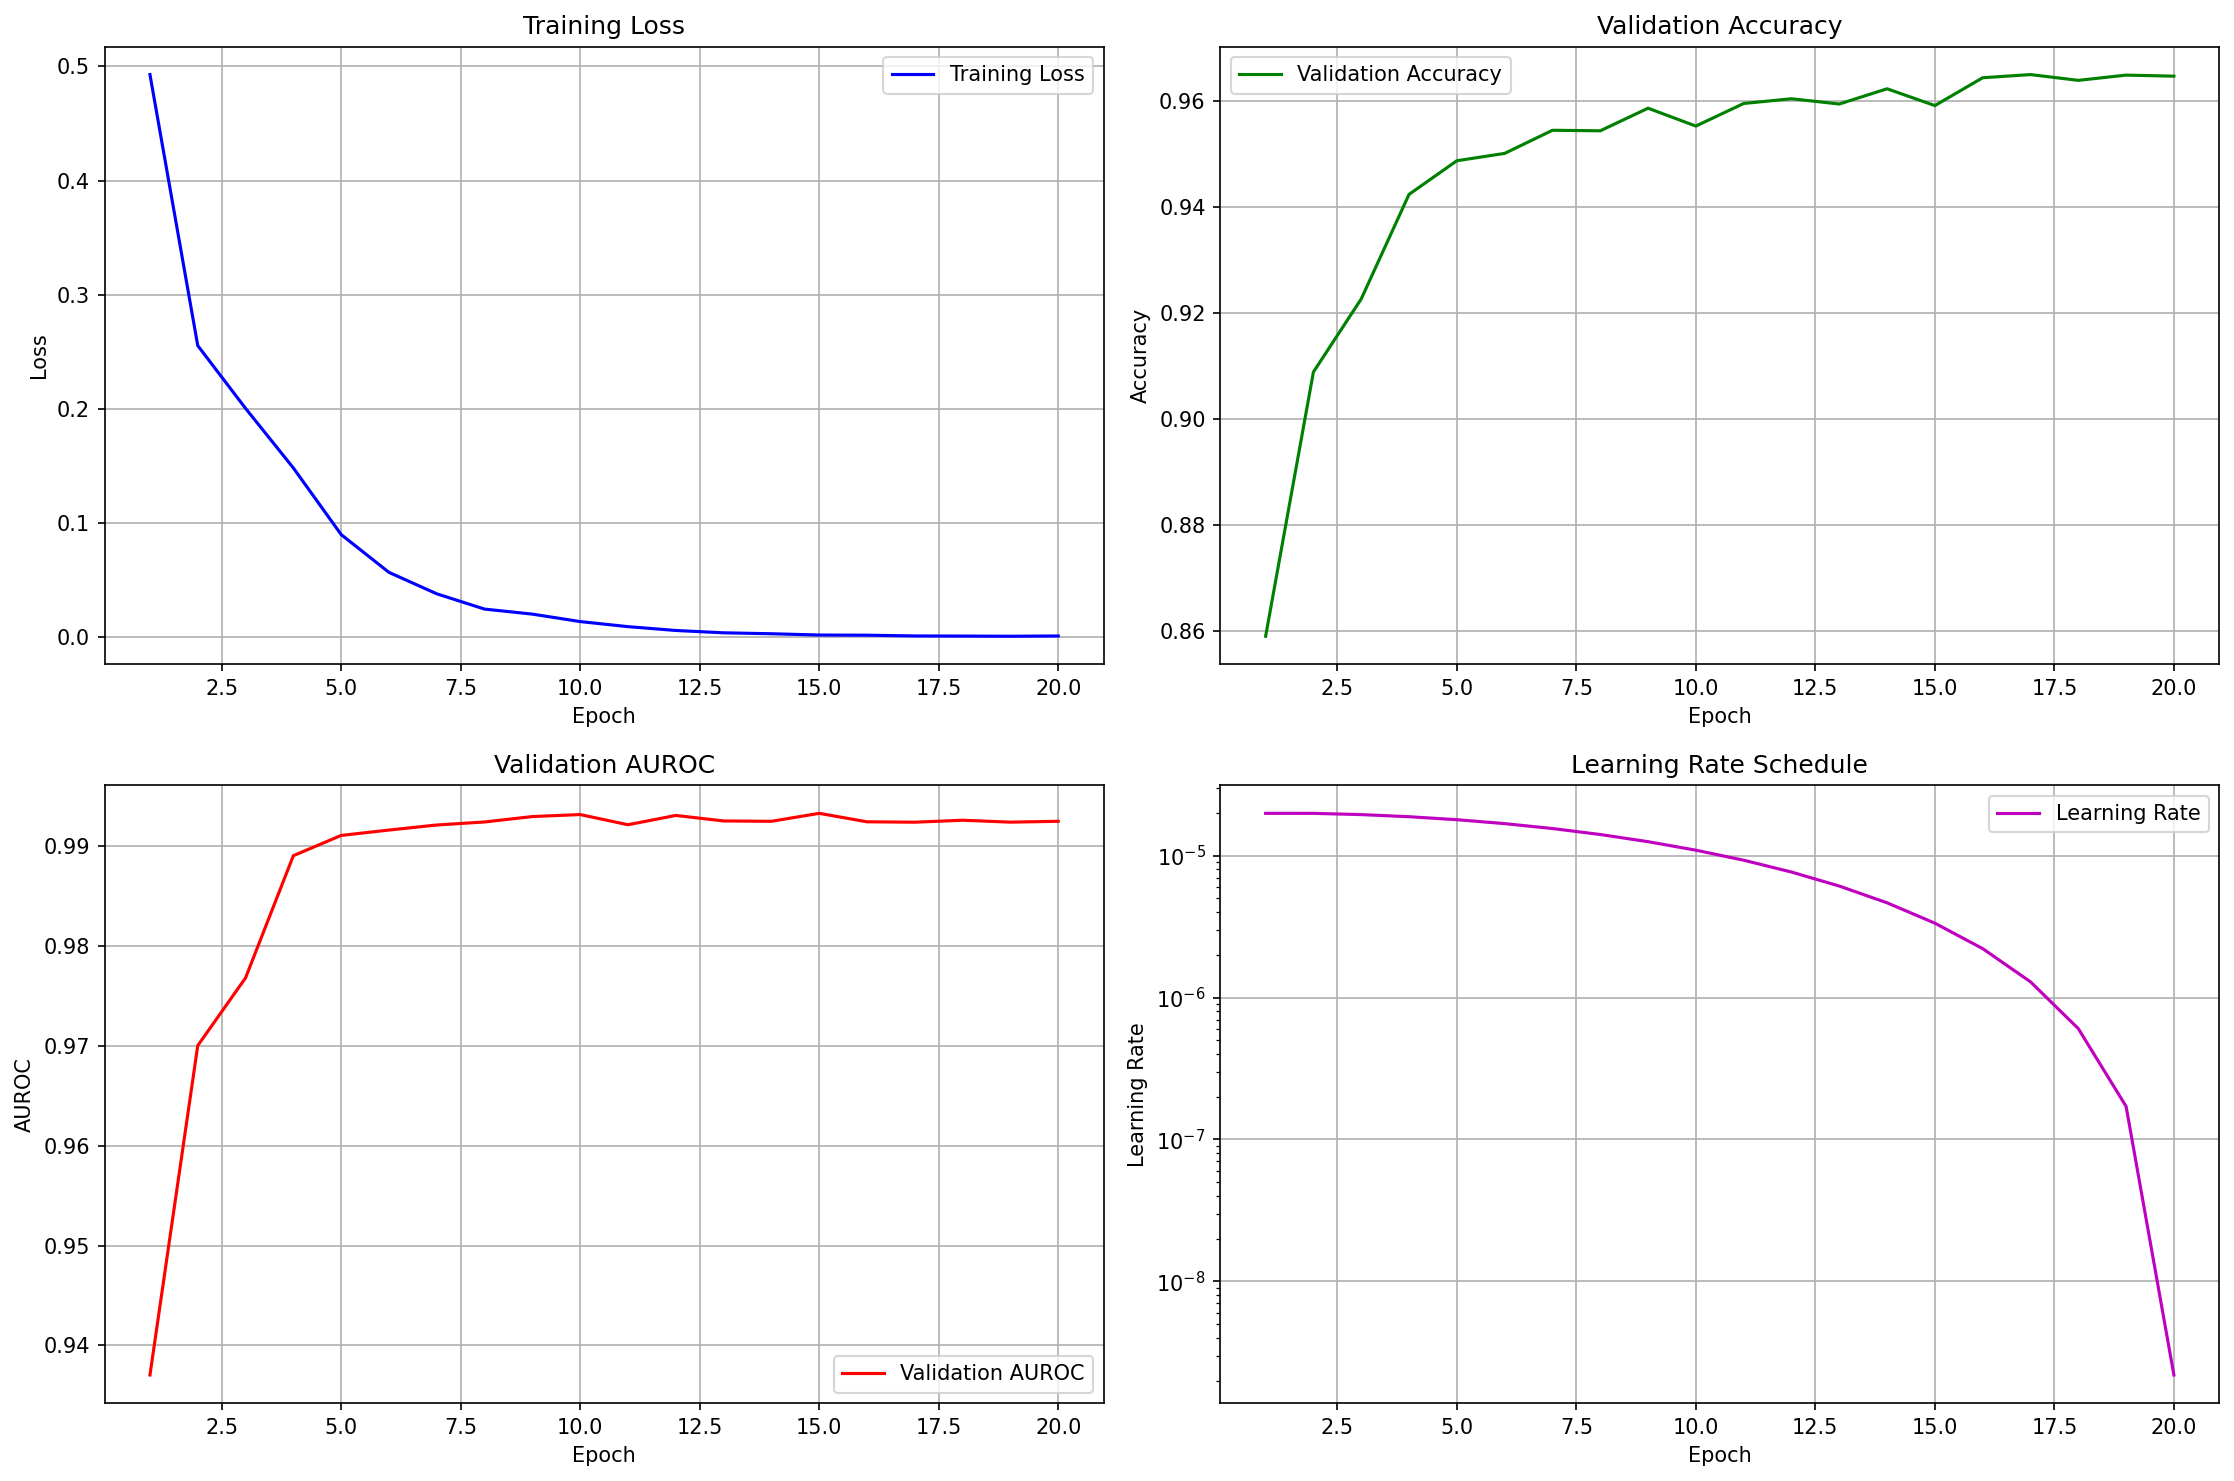
Grafico training (clicca per ingrandire)
Disclaimer Legale
ESCLUSIONE DI RESPONSABILITÀ: Il sistema di analisi fornito è uno strumento di supporto tecnico che non garantisce risultati infallibili. I risultati dell'analisi sono forniti "così come sono" (as-is) senza garanzie di alcun tipo, espresse o implicite. L'utente riconosce che possono verificarsi falsi positivi o falsi negativi e che nessuna tecnologia attuale può determinare con certezza assoluta l'origine o l'autenticità di un'immagine digitale. acquisizioniforensi.it, il suo proprietario, dipendenti e collaboratori declinano ogni responsabilità per qualsiasi danno diretto, indiretto, incidentale, consequenziale o punitivo derivante dall'uso o dall'impossibilità di utilizzo del servizio, inclusi ma non limitati a: (i) errori nella classificazione delle immagini; (ii) decisioni prese sulla base dei risultati dell'analisi; (iii) danni reputazionali o economici derivanti da valutazioni errate; (iv) perdita di dati o interruzioni del servizio. L'utilizzo del sistema implica l'accettazione integrale di questi termini e la rinuncia a qualsiasi pretesa risarcitoria. Per decisioni critiche si raccomanda sempre la consultazione di un esperto forense qualificato.