Home / Rilevatore di Plagio
Rilevamento plagio con Hashing Percettivo
Confronta due testi in italiano o inglese e individua copie, parafrasi e traduzioni con hashing percettivo, metriche lessicali e un modello neurale multilingue, con report PDF.
Incolla il testo originale e quello da confrontare: l'analisi individua copie, parafrasi e traduzioni.
Testo Originale
Testo da Confrontare
Analisi del plagio in corso...
Risultati dell'Analisi
Indicatore di plagio
0%
Similarità dell'Hash (Hamming)
0%
Similarità di Jaccard
0%
Similarità del Coseno
Statistiche
| Parole di contenuto nel testo originale | 0 |
| Parole di contenuto nel testo confrontato | 0 |
| Parole di contenuto in comune | 0 |
| Percentuale di parole in comune | 0% |
Hash Percettivi
| Hash del testo originale | - |
| Hash del testo confrontato | - |
| Distanza di Hamming | 0 |
Parole di contenuto in comune
Analizzatore avanzato di plagio basato su hashing percettivo
Questo strumento utilizza tecniche avanzate di analisi testuale per rilevare similitudini tra documenti. Combinando l'hashing percettivo con l'analisi semantica, è in grado di identificare potenziali casi di plagio anche quando il testo è stato leggermente modificato. Supporta l'analisi di testi in italiano e inglese, rilevando automaticamente la lingua; il modello neurale multilingue riconosce anche le parafrasi profonde e le traduzioni, e indica quali frasi corrispondono.
Inserisci il testo originale e il testo da confrontare negli appositi campi. L'analizzatore escluderà automaticamente articoli, preposizioni e congiunzioni, concentrandosi sulle parole che veicolano concetti, idee e informazioni sostanziali. Il sistema calcolerà diverse metriche di similarità tra cui:
Metriche di similarità utilizzate
Il sistema utilizza 8 diverse metriche per analizzare la similarità tra i testi da molteplici prospettive:
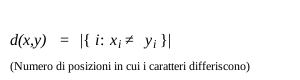
Distanza di Hamming
d(x,y) = |{i : xi ≠ yi}|
Confronta gli hash percettivi dei testi. Una distanza bassa indica forte somiglianza strutturale. Range: 0 (identici) → ∞ (diversi)
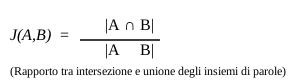
Similarità di Jaccard
J(A,B) = |A ∩ B| / |A ∪ B|
Misura le parole condivise tra i testi. Valori >0.7 indicano forte sovrapposizione lessicale. Range: 0-1 (0=nessuna parola comune, 1=identici)
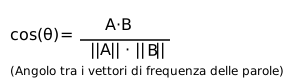
Similarità del Coseno
cos(θ) = (A·B) / (||A|| · ||B||)
Considera la frequenza delle parole. Robusta per identificare plagio con parafrasi. Range: 0-1 (1=distribuzioni identiche)
Similarità di Sørensen-Dice
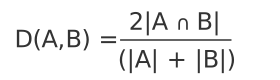
D(A,B) = 2|A ∩ B| / (|A| + |B|)
Simile a Jaccard ma dà maggior peso all'intersezione. Più sensibile nel rilevare sovrapposizioni parziali e parafrasamenti. Range: 0-1
Similarità TF-IDF Coseno
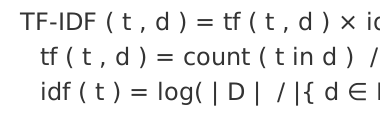
TF-IDF(t,d) = tf(t,d) × idf(t)
Pesa l'importanza delle parole nel contesto. Efficace per plagio di contenuti specialistici dove termini tecnici sono riutilizzati. Range: 0-1
Similarità Semantica
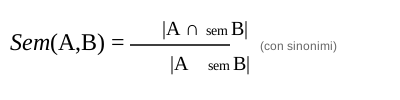
cos_sim(embed(A), embed(B))
Usa il modello neurale multilingue (paraphrase-multilingual-MiniLM-L12-v2) per calcolare la similarità semantica profonda tra i testi. Rileva parafrasamenti anche con vocabolario completamente diverso. Range: 0-1
Similarità Strutturale
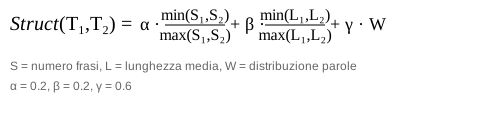
Struct(T1,T2) = f(frasi, lunghezza, ritmo)
Analizza organizzazione del testo: frasi, lunghezza, distribuzione. Identifica stessa struttura con parole diverse. Range: 0-1
Similarità N-grammi
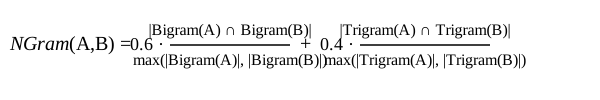
NGram(A,B) = Bigram ∩ Trigram
Confronta sequenze di 2-3 parole. Rileva frasi copiate o leggermente modificate. Range: 0-1
Come funziona l'algoritmo di rilevamento del plagio
L'algoritmo utilizza un approccio multi-livello che combina analisi lessicale, semantica e strutturale per identificare il plagio anche in testi parafrasati.
I testi vengono normalizzati (minuscolo, rimozione punteggiatura) e filtrati eliminando le stop words italiane (articoli, preposizioni, congiunzioni, verbi ausiliari). Rimangono solo le parole di contenuto con significato sostanziale.
Hash percettivo: Genera un'impronta digitale di 64 bit del testo (SimHash sulle coppie di parole consecutive), resistente a piccole modifiche. La similarità degli hash è riportata rispetto al caso: 0% è il valore di due testi indipendenti, 100% hash identici. Il punteggio finale indica quanto i testi si somigliano: stabilire se si tratta di plagio (o di citazioni, fonti comuni, testi standard) spetta a chi li esamina.
Embedding neurale multilingue: Il sistema utilizza il modello paraphrase-multilingual-MiniLM-L12-v2 per calcolare la similarità semantica profonda. A differenza del thesaurus, comprende il significato complessivo delle frasi e rileva parafrasi anche quando non viene riutilizzata nessuna parola dell'originale.
Metriche tradizionali:
- ✅ Hamming: Somiglianza degli hash
- ✅ Jaccard: Parole in comune
- ✅ Coseno: Distribuzione parole
- ✅ Dice: Enfasi sull'intersezione
- ✅ TF-IDF: Peso semantico termini
Metriche avanzate:
- ✅ Semantica: Embedding neurale multilingue
- ✅ Strutturale: Organizzazione testo
- ✅ N-grammi: Sequenze di parole
Il sistema utilizza un algoritmo di ponderazione dinamica che adatta i pesi delle metriche in base alle caratteristiche dei testi:
| Condizione rilevata | Adattamento algoritmo |
|---|---|
| Molti sinonimi trovati (>15%) | Aumenta peso similarità semantica |
| Alta similarità strutturale (>80%) | Aumenta peso struttura fino al 40% |
| Nessuna parola in comune | Limita punteggio massimo al 30% |
| Parafrasamento evidente | Formula speciale con enfasi su struttura e sinonimi |
Scala di valutazione finale:
💡 L'algoritmo è ottimizzato per rilevare sia copia-incolla diretti che parafrasamenti sofisticati, bilanciando precisione e sensibilità per minimizzare falsi positivi e falsi negativi.
Questo strumento è pensato come supporto per l'analisi del plagio e non sostituisce il giudizio umano. I risultati forniscono indicazioni sulla similarità tra i testi, ma è consigliabile una valutazione esperta per determinare l'effettiva presenza di plagio, specialmente in contesti accademici o legali.